

Новые возможности отказоустойчивой кластеризации Windows Server 2019: полный обзор
В случае сбоя одного сервера балансировщик нагрузки перенаправляет запросы на работающие серверы, обеспечивая регулярную доступность сервиса. Для компаний, которые зависят от выделенных серверов для работы важнейших приложений и компаний, крайне важно гарантировать максимальное время безотказной работы. Поскольку цифровые технологии продолжают развиваться, простои — это нечто большее, чем просто неудобство. Использование этих правил с реальными инструментами и облачными сервисами дает командам возможность создавать отказоустойчивые инфраструктуры, готовые к любым вызовам. Поставщики облачных услуг предлагают встроенные возможности резервирования и аварийного IWIHOST переключения, такие как развертывание в нескольких зонах доступности (Availability Zones), автоматизированные базы данных аварийного переключения и глобальную балансировку нагрузки.
Основная цель отказоустойчивой кластеризации — обеспечение максимальной степени доступности инфраструктуры. Еще одна функция безопасности, доступная в Windows Server 2019, — усиление защиты кластера. Самовосстанавливающийся кластер часто может проверять состояние своих узлов и оперативно восстанавливать их, если были обнаружены какие-либо проблемы. С выпуском Windows Server 2019 сотрудники Microsoft еще раз улучшили свой метод обеспечения безопасности. Таким образом, вы найдете способ простой миграции виртуальных машин между отказоустойчивыми кластерами, работающими в одном наборе кластеров. Наборы кластеров могут существенно упростить администрирование отказоустойчивого кластера в вашей инфраструктуре различными способами.
Системный администратор обычно создает автоматическое уведомление, сигнализирующее клиентам о том, что произошло переключение. Множество путей, резервные компоненты, а также удаленная или облачная поддержка — все это помогает обеспечить безопасный и постоянно подключенный путь. Часто, в зависимости от сложности интернет-хостинга, система может даже иметь третий сервер, на котором работают основные элементы, необходимые для предотвращения простоев во время переключения.
Понимание структуры аварийного переключения
В таких средах особенности отказоустойчивых кластеров полезны для тех, кто работает со всем жизненным циклом информации. Информационный и аналитический бизнес, который сейчас работает в каждой сфере деятельности, имеет усовершенствованные операционные требования, обычно изобилует строгими правилами соответствия и управления и должен управлять и анализировать значительные объемы данных. Расширяя отказоустойчивые кластеры, организации могут реплицировать данные между несколькими центрами знаний. Если один посредник данных выходит из строя, цели и поставщики могут быть переключены на другой посредник знаний, не нарушая при этом работу клиентов. Давайте посмотрим на ряд практических современных приложений для отказоустойчивых кластеров, которые могут широко использоваться в нашем цифровом мире.
Примеры механизмов аварийного переключения
- Подводя итог, аварийное переключение — это сложная, но важная сторона современных вычислений, важность которой может только возрастать по мере того, как будет возрастать наша зависимость от цифровых технологий.
- Хотя это обеспечивает больший контроль над процессом аварийного переключения и позволяет оценить состояние дел до переключения на систему резервного копирования, я удивлюсь, если это действительно необходимо.
- Если один узел выходит из строя, остальные узлы продолжают справляться с нагрузкой, зачастую без заметного влияния на производительность.
- Как и при отказе сервера, переключение позволяет ИТ-директорам изменять роли серверов, чтобы резервный сервер превратился в основной сервер.
- Однако это также может быть проблематичным, поскольку эффективность серверов может серьезно снизиться в случае сбоя конфигурации.
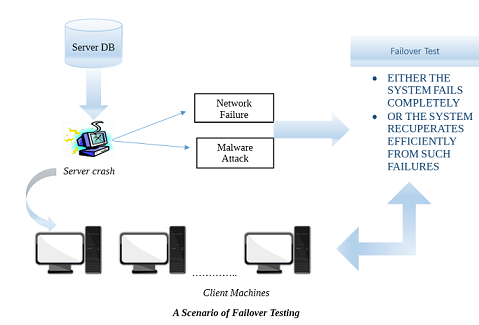
Структура аварийного переключения — это стратегия проектирования системы, которая обеспечивает непрерывную доступность услуг путем регулярного переключения на резервные источники при возникновении сбоев. Это может предотвратить несанкционированный доступ пользователей или гаджетов к порту аварийного переключения. Несмотря на препятствия, отказоустойчивые кластеры являются превосходным решением для критически важных для бизнеса систем, обеспечивают надежную страховку для резервного копирования и восстановления, а также могут повысить доступность и стимулировать новейшие инновации в области знаний. Например, клиенты Purple Hat Enterprise Linux (RHEL) могут создавать отказоустойчивые кластеры высокой доступности с помощью расширения Red Hat Enterprise Linux Excessive Availability Extension (RHEV).